Web記事も、これまでの本棚と同じ仕組みで電子化して読めるようにした。きっかけは動画からの変換の制約だ。YouTube側のアクセス制限で伸び悩み、代替ルートとして育った機能だ。
今回は、その変換の流れと、実際にぶつかった技術的な落とし穴を振り返る。
この記事でわかること
- Web記事も同じ仕組みで本棚に変換できるようになった実情(2026年9月時点の記録)
- 変換の4つのステップ
- 文字コード・JS描画サイトでぶつかった技術的な落とし穴
- 要約の情報源としてWebFetchを使わない理由
- 登録した記事の実績
Web記事も同じ仕組みで本棚に変換できるようになった
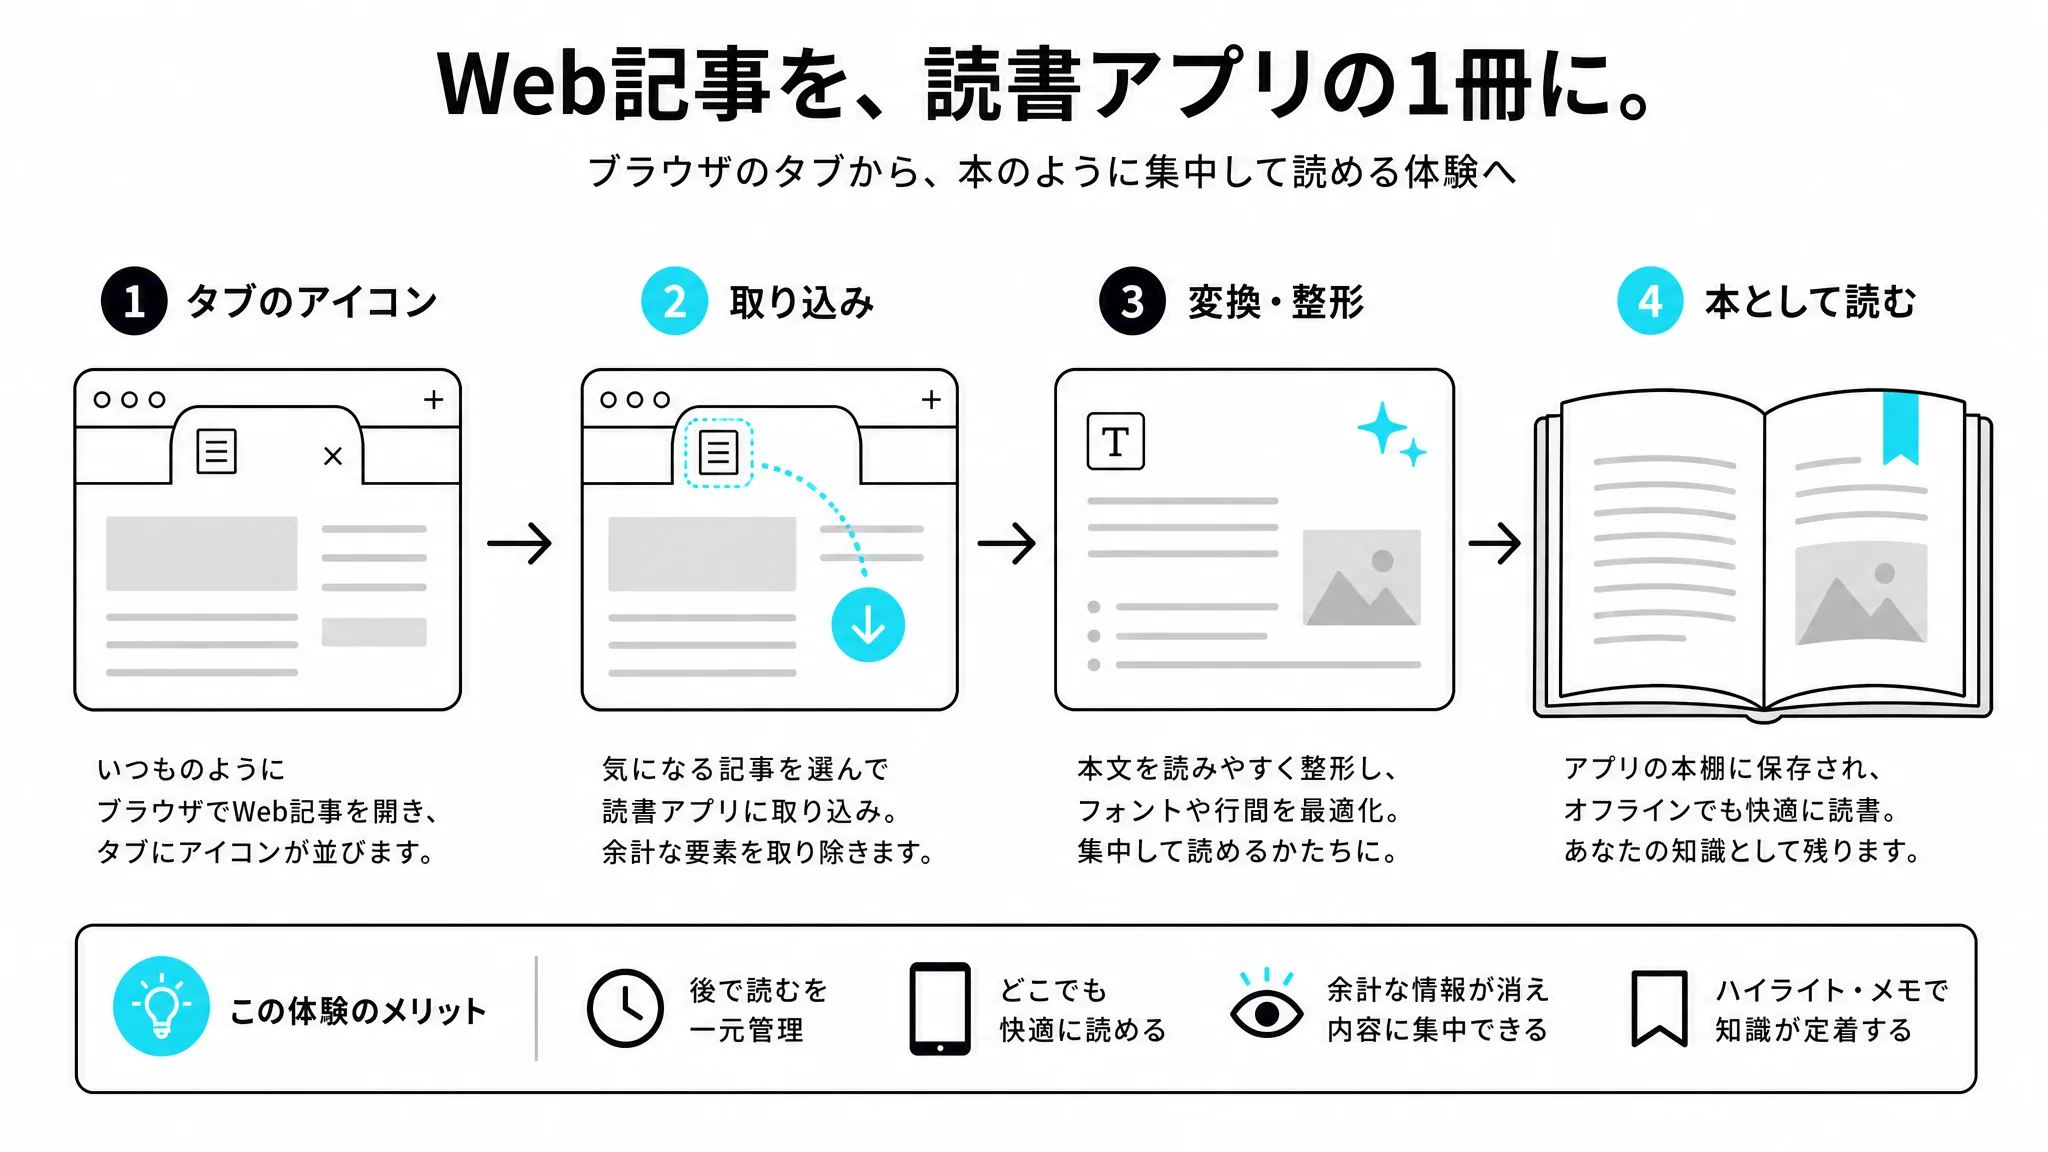
紙の本・動画に続いて、Web記事も本棚の仲間に加わった。 本棚の仕組みや要約の書き方は動画版のものをそのまま流用でき、新しく作り込んだのはページから本文を取りだす部分だけだった。次の章で、その変換の流れを振り返る。
変換は4つのステップで行う
手順自体は、動画版とほぼ同じ骨格で組んである。
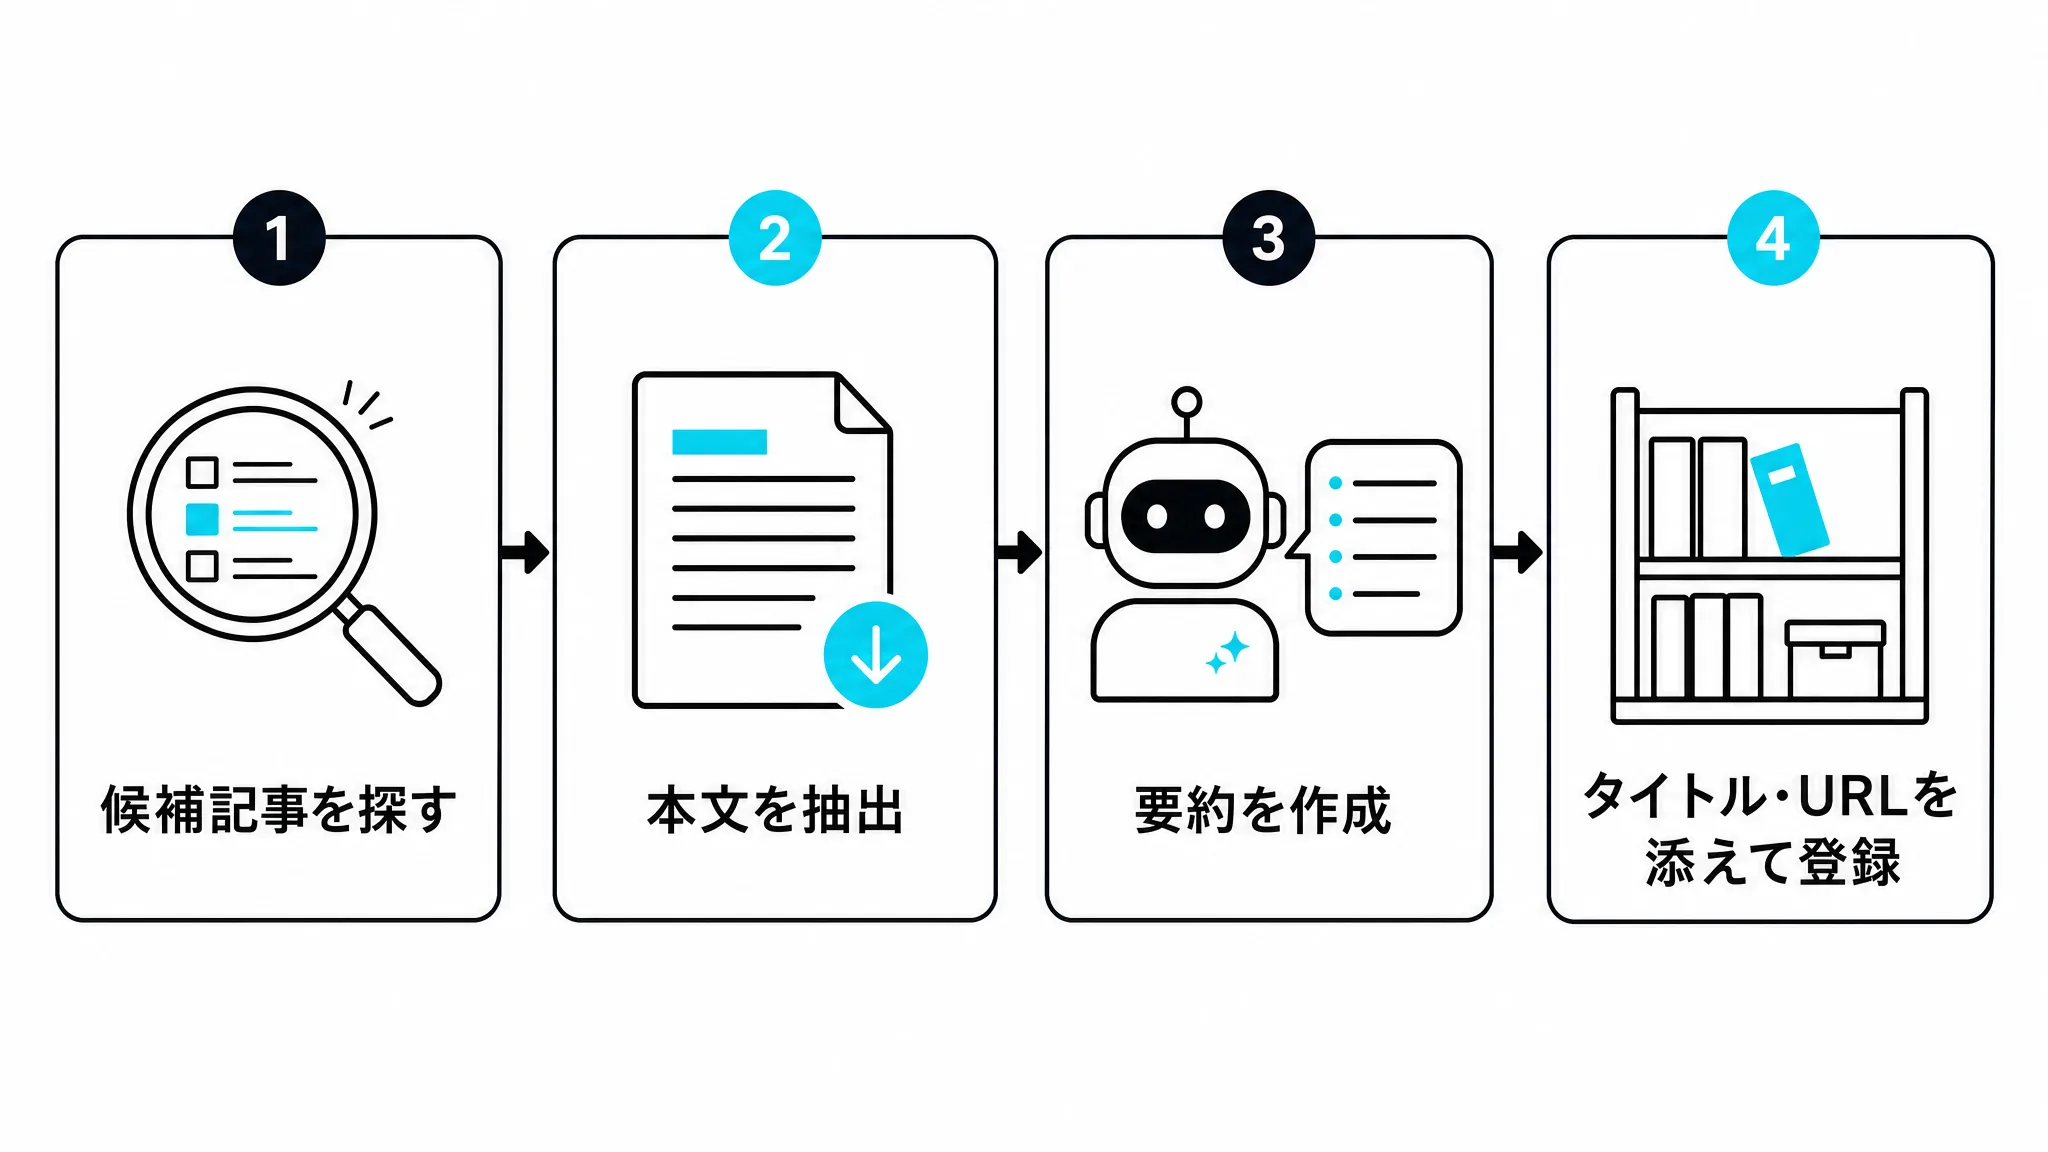
ペイウォールのない候補記事を探す
まず候補選びの段階で、読める記事かを見極める。検索などを使い、会員登録や課金の壁が無い記事を候補として探す。
HTMLを取得して本文テキストを抽出する
候補が決まったら、ページの中身から本文だけを取りだす。HTMLを取得し、本文が入っている部分のタグから文章を抜き出す。
AIエージェントが本文を読み要約文を作成する
抽出した本文は、続けてAIエージェントに読んでもらう。動画版と同じく、簡潔にまとめる書き方を基本にし、専門用語は独立ページに切り出すルールを踏襲している。
タイトルや出典URLを添えて本棚へ登録する
要約ができたら、最後に本棚へ加える。動画版と同じく、あとから見返したときに出どころをすぐ確認できるようにする狙いがある。
文字コードの違いという落とし穴があった
思わぬところで、文字コードの違いにつまずいた。 一部の日本語ニュースサイトはHTMLがUTF-8ではなく別の文字コードで配信されている。そのまま決め打ちでデコードすると本文が文字化けしてしまうため、ページの文字コード指定を確認してから読み込む必要があった。
JSで描画されるサイトでも本文は抽出できた
JavaScriptで組み立てられているサイトも、あきらめずに済んだ。静的なHTMLのタグをそのまま拾おうとするとノイズばかりで、一見取得できないように見えるサイトもあった。
実際には特定の領域に本文がサーバー側で埋め込まれていた。その開始位置から次のセクション(関連記事など)がはじまる直前までを切り出せば、本文全体を着実に抽出できると分かった。
要約の情報源としてWebFetchは使わない
要約の元にする情報源は、あえて絞り込んでいる。 同じ記事をAIエージェントのWeb取得機能(WebFetch)で要約させたことがある。業種名やイベント名、金額といった固有名詞・数値が、複数箇所で実際と食い違っていた。
HTMLから直接抽出した本文と突き合わせて判明したことで、数値や固有名詞を含む要約の情報源としては使わない方針にした。
登録した記事の実績はこれくらいになった
ここまでの積み重ねで、それなりの数の記事を登録できた。同じ手法で、複数のメディアから合わせて11本の記事を追加登録した。いずれもキャリア戦略やAI時代の人材育成など、関心のある領域の記事だ。
抽出の精度にこだわるほど要約の信頼度が上がった
入り口で手を抜くと、後工程にそのまま響いてくる。 本文の抽出が粗いと、その後どれだけ丁寧に要約しても間違った情報を含んだままになる。
この姿勢は、MOCO Worksのサービスにも通じている。
参考・出典情報
(本記事は社内技術ドキュメントによる裏取り起点のため、外部出典なし)